

Ich habe bei Kunden schon öfter erlebt, dass neue Hardware angeschafft wurde und der erhoffte Performance-Gewinn ausblieb. Schneller war es hinterher vielleicht schon, aber nicht so viel schneller wie erwartet. Bei der Fehlersuche bin ich dann etwa auf PCIe-Steckplätze mit zu wenig Bandbreite gestoßen oder auf Netzwerkkarten, HBA-Controller und Switches, die mit der gewünschten Leistung nicht mithalten konnten.
Die gesamte IT-Infrastruktur zu erneuern, ist kostspielig und oft gar nicht nötig. Deshalb werden häufig nur einzelne Komponenten modernisiert. Vorher möchte ich wissen, welche Leistung tatsächlich gebraucht wird, was das System ausbremst und welche Möglichkeiten die vorhandene Hardware noch bietet. Manchmal helfen schon andere Einstellungen oder bislang ungenutzte Funktionen. Wird neue Hardware benötigt, sollten auch die weitergenutzten Komponenten zur gewünschten Leistung passen. Eine genaue Analyse kann so unnötige Anschaffungen und spätere Nacharbeit ersparen.
Aus diesem Grund habe ich diesen Test gemacht. Als Beispiel habe ich auf einem alten Laborsystem iSCSI mit iSER verglichen. Mit derselben Hardware stieg der Durchsatz deutlich. Danach wurden andere mögliche Engpässe sichtbar, etwa bei der Rechenleistung des Servers und der Anbindung der Platten. Genau diesen Zusammenhang möchte ich veranschaulichen. Wenn eine Begrenzung wegfällt, kann eine andere Komponente zum Engpass werden. Deshalb messe ich nach einer Änderung erneut und prüfe, ob die Leistung für den tatsächlichen Bedarf ausreicht.
Was soll der Speicher eigentlich leisten?
Bevor ich messe, möchte ich wissen, wo es im Alltag hakt. Dauert die Datensicherung zu lange? Reagieren virtuelle Maschinen träge? Wartet eine Datenbank auf bestätigte Schreibzugriffe? Große Dateien zu übertragen stellt andere Anforderungen als viele kleine, verteilte Zugriffe mit möglichst kurzer Antwortzeit.
- Welche Durchsätze und Antwortzeiten braucht die Anwendung unter ihrer üblichen Last?
- Wie viele Systeme greifen gleichzeitig zu, und wie wichtig sind synchrone Schreibzugriffe?
- Welche Kapazität, Ausfallsicherheit und Reserven werden in den nächsten drei bis fünf Jahren gebraucht?
Meine Tests betrachten große sequenzielle Übertragungen. Sie machen den Einfluss des Transportwegs sichtbar. Für die Auswahl eines Speichers für Datenbanken oder viele virtuelle Maschinen würde ich zusätzlich deren Lastprofil heranziehen.
Der Testaufbau im alten Laborsystem
Für die Messung vom September 2026 habe ich Storage-Server und Client aus der Servergeneration um 2010 verwendet. Der Datenpool besteht aus klassischen Festplatten. Die Intel-NVMe-Laufwerke dienen als gespiegeltes ZFS-Schreiblog, kurz SLOG.
| Komponente | Ausstattung |
|---|---|
| Storage-Server | Dell PowerEdge R710, 12 logische CPUs, Oracle Linux mit OpenZFS |
| Platten | 72 NL-SAS-Festplatten mit 1 TB und 7.200 U/min in drei HPE-D2700-Enclosures |
| Pool | 24 Dreifach-Mirrors, gespiegeltes SLOG auf zwei Intel DC P3700 |
| Plattenanbindung | ein SAS-HBA (LSI SAS2008) an PCIe 2.0 x8 |
| Netz | QDR-InfiniBand, 32 Gbit/s nach Leitungskodierung, vor Protokoll-Overhead |
| Client | HP ProLiant DL380 G7, 24 logische CPUs, OLVM-Host |
| Target und Initiator | LIO und Open-iSCSI |
Beide Protokolle greifen auf dieselbe LUN zu, ein ZFS-Volume mit 200 GiB, 16 KiB Blockgröße und abgeschalteter Kompression. Darauf liegt ein XFS-Dateisystem mit einer 100 GiB großen Testdatei. iSCSI läuft als TCP/IP über InfiniBand, kurz IPoIB. iSER nutzt dieselben Adapter über RDMA. Server, Platten, Verkabelung und Einstellungen bleiben für den Vergleich gleich.
fio --name=seqwrite --filename=/test/fio.file --size=100G \
    --rw=write --bs=512k --direct=1 --ioengine=libaio --iodepth=16 \
    --refill_buffers --time_based --runtime=180
Je Protokoll und Richtung vergleiche ich einen Lauf über 180 Sekunden. direct=1 umgeht den Seiten-Cache des Clients. Der ZFS-Cache auf dem Storage-Server bleibt aktiv, in beiden Leseläufen kommen die Daten weitgehend aus dem ARC im Arbeitsspeicher. Die hohen Lesewerte zeigen deshalb vor allem, was Server, Transportweg und Client gemeinsam leisten.
Begleitend habe ich mit mpstat die CPU-Auslastung je Kern und mit zpool iostat die Poolaktivität betrachtet. Gerade diese Werte helfen zu verstehen, warum der Durchsatz an einer bestimmten Stelle stehen bleibt.
Warum der CPU-Durchschnitt nicht reicht
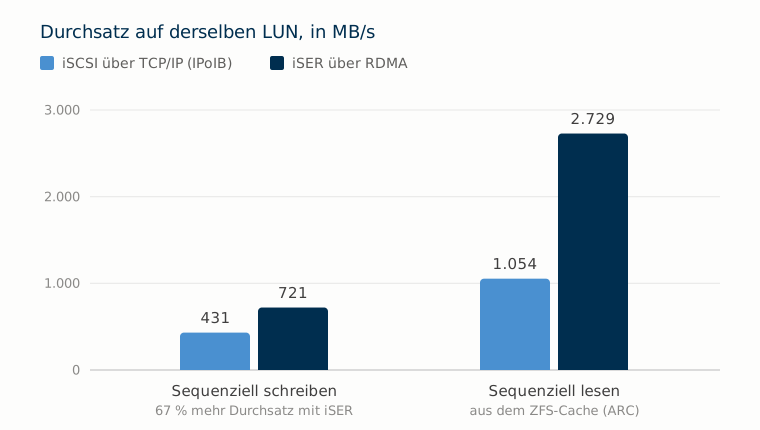
Mit iSCSI erreicht der Client beim Schreiben 431 MB/s. Auf den ersten Blick könnte man nun schnellere Platten vermuten. Die CPU-Anzeige des Storage-Servers lässt schließlich noch reichlich Reserve erkennen. Erst der Blick auf die einzelnen Kerne zeigt ein anderes Bild.
Ein Kern ist nahezu ausgelastet. Rund 88 % seiner Zeit entfallen auf Softirqs, also die Verarbeitung von Software-Interrupts, hier passend zur hohen Last durch den Netzwerkempfang. Ein weiterer Kern verbringt rund 75 % mit Systemarbeit. Beim Lesen zeigt sich ein ähnliches Muster am Client, ein Kern erreicht rund 95 % Softirq-Zeit, während die CPU-Gesamtauslastung bei nur rund 5 % liegt. Das spricht deutlich für eine Begrenzung im TCP/IP-Verarbeitungspfad dieses Aufbaus.
Schon bei der Vorbereitung zeigte sich, dass eine angepasste Cache-Einstellung den Durchsatz verbessern konnte. Es lohnt sich also, vor einem Hardwarekauf auch die Konfiguration zu prüfen.
Was der Wechsel auf iSER bringt
iSER erweitert iSCSI um RDMA. Die Adapter übertragen Nutzdaten direkt in dafür bereitgestellte Speicherbereiche. Das verringert die Arbeit im TCP/IP-Datenpfad. Die Voraussetzungen waren im Lab bereits vorhanden, beide Seiten hatten RDMA-fähige Adapter und die passende Software-Unterstützung. Für den Vergleich habe ich ein zweites Portal am Target eingerichtet und den Client darüber angemeldet.
Für alle Spalten seitlich scrollen.
| Aspekt | iSCSI | iSER |
|---|---|---|
| Sequenziell schreiben | 431 MB/s | 721 MB/s |
| Latenz Schreiben (Median) | 17 ms | 11 ms |
| Sequenziell lesen aus dem ARC | 1.054 MB/s | 2.729 MB/s |
| Latenz Lesen (Median) | 7,8 ms | 3,0 ms |
Die Latenzwerte sind die von fio gemessenen Zeiten von der Übergabe eines I/O bis zu seiner Fertigmeldung, kurz clat. Typische Zugriffe werden mit iSER schneller abgeschlossen. Bei seltenen Schreibausreißern ist das Bild anders, das 99,9. Perzentil steigt von 79 auf 201 ms. Für Anwendungen, die empfindlich auf solche Pausen reagieren, gehört dieser Wert neben den Durchsatz.
Für mich ist entscheidend, dass der vorhandene Speicher deutlich mehr liefert, ohne dass ich dafür Hardware ausgetauscht habe. Das macht den Transportweg zu einem sinnvollen Ansatzpunkt für die Optimierung dieses Systems.
Mehr Durchsatz bringt andere Grenzen in den Blick
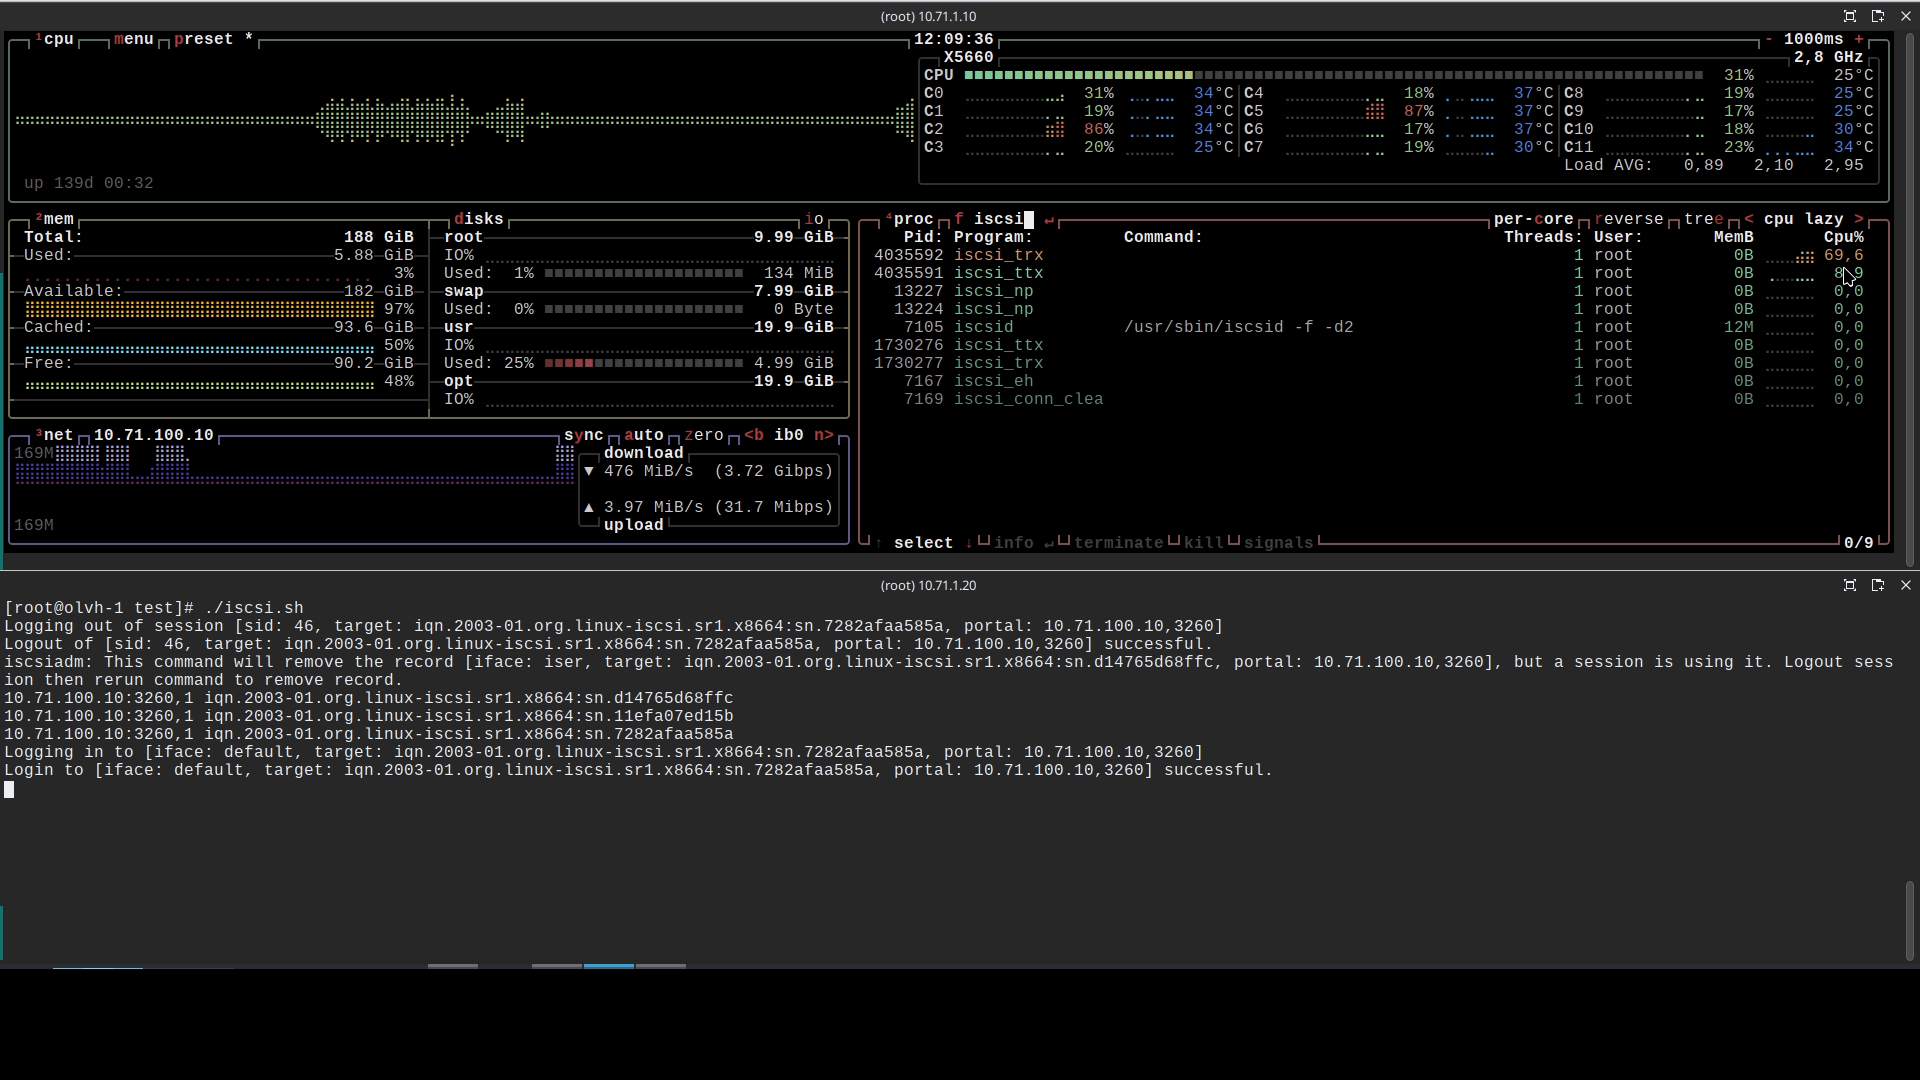
Nach dem Wechsel auf iSER verteilt sich die CPU-Arbeit beim Schreiben breiter. Der hohe Softirq-Anteil auf einem einzelnen Kern geht deutlich zurück. Die dokumentierten Momentaufnahmen zeigen über alle Kerne gemittelt rund 31 % Systemzeit mit iSCSI und 69 % mit iSER. Der Transport wird entlastet, zugleich kommen jetzt aber mehr Daten an, für die ZFS Prüfsummen berechnen, Blöcke verwalten und Schreibzugriffe ausführen muss.
Dazu kommt der Aufbau des Speichers. In einem Dreifach-Mirror wird jeder Datenblock dreimal abgelegt. Die Schreiblast auf den Laufwerken liegt deshalb deutlich über dem, was der Client liefert. Alle 72 Platten hängen an einem SAS-HBA mit PCIe 2.0 x8. Bei den höheren Schreibraten rücken damit die HBA-Anbindung, das Pool-Layout und die Rechenleistung des alten Servers als nächste Grenzen in den Blick.
Beim Lesen fällt der Gewinn größer aus, weil die Daten bereits im ARC liegen und die Platten kaum Arbeit übernehmen müssen. Das erklärt, warum derselbe Aufbau beim Lesen 2.729 MB/s erreicht, beim Schreiben aber 721 MB/s. Die Werte beschreiben unterschiedliche Belastungen desselben Systems.
Wo eine Investition anschließend ansetzen kann
Bei diesem System würde ich vor einem Plattentausch die Anbindung und die Serverplattform betrachten. Ein weiterer oder leistungsfähigerer HBA kann helfen, wenn auch PCIe-Steckplätze und die Pfade zu den Enclosures zusätzliche Bandbreite hergeben. Eine neuere Plattform kann zugleich mehr Rechenleistung und schnellere Schnittstellen bieten. Welche Variante sinnvoll ist, hängt von der benötigten Leistung und den Kosten ab.
Auch das Speicherdesign bietet Spielraum. Auf demselben Server lassen sich getrennte Pools für unterschiedliche Aufgaben betreiben, etwa ein RAID-Z-Pool für große, überwiegend sequenziell übertragene Dateien und ein Pool aus gespiegelten Laufwerken für Datenbanken mit vielen kleinen, verteilten Zugriffen. Entscheidend ist das Zugriffsmuster, nicht allein die Dateigröße. Ein Dreifachspiegel bietet dabei zusätzliche Ausfallsicherheit, ist aber keine Voraussetzung für Datenbankbetrieb.
Bei großen Schreibblöcken kann RAID-Z weniger Datenverkehr über den HBA verursachen als ein Dreifachspiegel. Es schreibt Nutzdaten plus Parität statt drei vollständiger Kopien. Daraus ergibt sich bei gleicher Nutzdatenrate ein möglicher Vorteil für die Bandbreite der Plattenanbindung. Wie groß er ausfällt, hängt von Blockgröße, Laufwerkszahl und Paritätsstufe ab. RAID-Z1, RAID-Z2 und RAID-Z3 tolerieren einen, zwei beziehungsweise drei Laufwerksausfälle je Gruppe, diese Anforderung gehört ebenfalls zur Auswahl.
Blockgrößen und Cache-Einstellungen lassen sich je Dataset oder ZFS-Volume an die Aufgabe anpassen. Unterschiedliche RAID-Layouts gezielt einzelnen Anwendungen zuzuordnen, erfordert dagegen getrennte Pools mit eigenen Laufwerken. Nutzen diese denselben HBA, teilen sie sich weiterhin dessen Bandbreite. Ein Wechsel vom vorhandenen Mirror- zum RAID-Z-Layout braucht eine geplante Datenmigration. Auch ein passendes Design kann also Reserven erschließen, bevor zusätzliche Hardware nötig wird.
- OpenZFS zu RAID-Z und Paritätsaufwand
- OpenZFS zur Abstimmung auf unterschiedliche Lastprofile
- OpenZFS zu Pools und gespiegelten Laufwerken
Für RDMA müssen Netzwerkkarten, Betriebssystem, Virtualisierung und Storage zusammenpassen. Über Ethernet ist RoCE eine Möglichkeit, für die auch das Switch-Netz passend ausgelegt und konfiguriert sein muss. Eine Nachrüstung kann sich gegenüber einem vollständigen Speichertausch lohnen. Sie sollte aber als Gesamtpaket verglichen werden, einschließlich Arbeitszeit und Betrieb. Eine passende RDMA-Infrastruktur lässt sich später gegebenenfalls auch für NVMe over Fabrics nutzen.
Manchmal genügt ein gezielter NVMe-Einsatz, etwa als SLOG für synchrone Schreibzugriffe, als L2ARC für geeignete Leselasten oder als Special vdev für Metadaten und ausgewählte kleine Blöcke. Ein Special vdev enthält dabei dauerhafte Pooldaten und braucht entsprechende Redundanz. Wenn viele kleine Zugriffe auf die Platten die Anwendung ausbremsen, kann All-Flash wiederum genau die richtige Investition sein.
Wie ich die Ergebnisse einordne
Die Messungen veranschaulichen den Effekt in diesem alten Laborsystem. Der Abstand zwischen den Protokollen ist kein allgemeiner Faktor. Aktuelle CPUs, Netzwerkkarten und natives Ethernet können bei iSCSI ein anderes Bild ergeben als das hier verwendete IPoIB. Ein vollständiger Vergleich aller Lastprofile oder der SLOG-Wirkung war nicht das Ziel.
Der Anstoß war ein erster Test vom April 2025 auf einem kleineren Aufbau mit zwei HP DL380 G7, 25 NL-SAS-Platten und RAID-Z2. Schon dort fiel der Unterschied beim Wechsel auf iSER auf. Das folgende Video zeigt diesen damaligen Ablauf. Die Tabellen und das Diagramm oben beruhen auf den neuen fio-Läufen vom September 2026.
Der Wechsel von iSCSI zu iSER im ersten Test von 2025
Was das für die eigene Umgebung bedeutet
Wenn die nächste Storage-Erneuerung ansteht, würde ich diese fünf Schritte vor die Einkaufsliste setzen.
- Klären, was die Anwendung heute und in den nächsten Jahren braucht.
- Die Ursache entlang der beteiligten Systeme und Verbindungen suchen, statt nur die vermeintlich zu langsame Komponente zu betrachten.
- Im Bestand optimieren, etwa durch angepasste Einstellungen, eine bessere Lastverteilung oder vorhandene Funktionen.
- Erneut messen und prüfen, was sich verbessert hat und wo jetzt Grenzen sichtbar werden.
- Gezielt investieren und die Komponenten so auswählen, dass sie gemeinsam die Anforderungen erfüllen.
Dieses Vorgehen lässt sich auch auf andere Performance-Probleme übertragen. Ich möchte vor einem Kauf wissen, was sich mit den vorhandenen Mitteln erreichen lässt und wo neue Hardware tatsächlich gebraucht wird. Erfüllt das System anschließend die Anforderungen, muss nicht sofort jede weitere Grenze beseitigt werden. So lassen sich Investitionen nach Bedarf und Budget planen und unnötige Kosten und Umbauten vermeiden.